ABCコンテスト 過去問感想 → ■
ARCコンテスト 過去問(~057, A・B難易度)感想 → ■
ARCコンテスト 過去問(~057, C難易度)感想 → ■
全体感想
ここからE問題表記です。何とか埋まりました。面白かったー(^^)
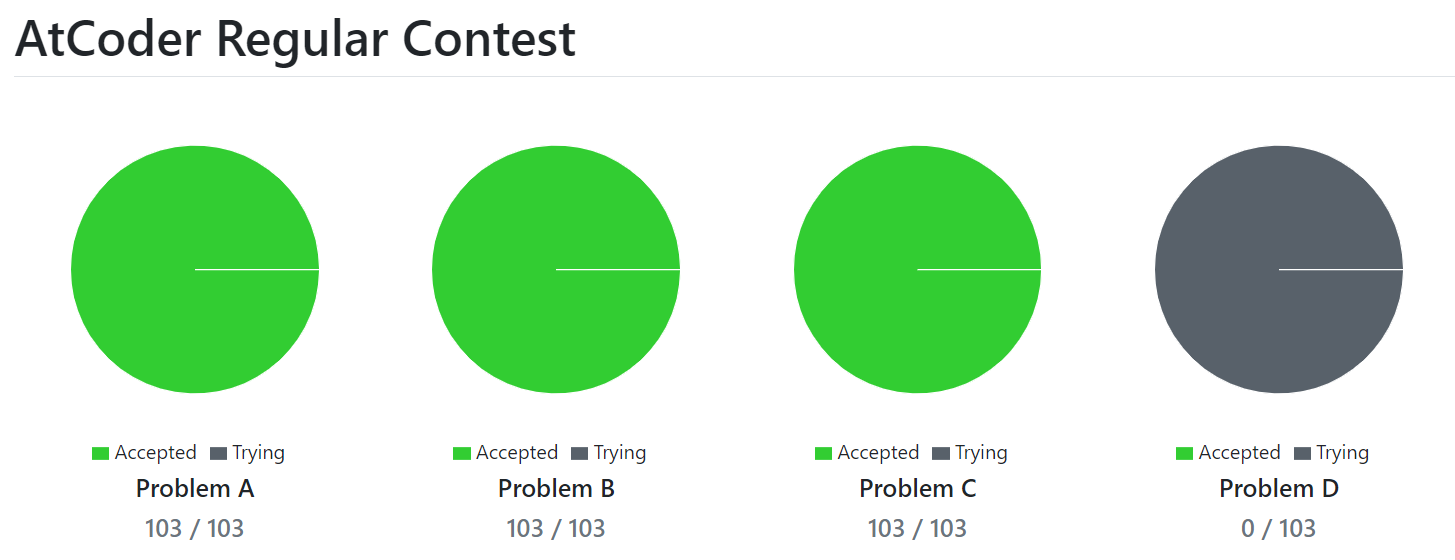
難易度は、~057のC問題を引き継いでいる印象があります。
ただ、こちらの方が易問が少なくて密度が濃いという印象でした。
難問リスト
個人的に数時間単位でかかったものなど。考察が難しかったもの、実装が難しかったものなどごちゃまぜ。一応雑にリストアップしておきます。個人差もあるかと思います。
・ARC065 へんなコンパス
・ARC068 Snuke Line
・ARC070 NarrowRectangles
・ARC080 Young Maids
・ARC085 MUL
・ARC086 Summggling Marbles
・ARC087 Prefix-free Game
・ARC089 GraphXY
・ARC093 Bichrome Spanning Tree
・ARC096 Everything on It
・ARC098 Range Minimum Queries
・ARC101 Ribbons on Tree
個別感想
058 <span>和風いろはちゃん</span>
問題文:
■ 自分の提出:
■どういう状態を持てばよいか → 右から見て部分和で作れている17以下の集合。
解説PDFが違うことやっているように見えたけど、私の持ち方で常に含んでいる0番を除くと同じっぽい?bitに直すとdpの更新は等差数列的な部分の和だったので、numpyで綺麗に書けた。
059 <span>キャンディーとN人の子供</span>
問題文:
■ 自分の提出:
■べき乗和を畳み込んでいく感じの計算になる。
このFFTを使った。
060 <span>高橋君とホテル</span>
問題文:
■ 自分の提出:
■$2^n$ 進む場合の値を持つ。みたいな発想も割と身についてきた?
061 <span>すぬけ君の地下鉄旅行</span>
問題文:
■ 自分の提出:
■駅と会社の組を頂点に持つグラフを考える。ところまではすぐに分かる。
乗り換えてくるとき、元の会社がどれの場合も区別する必要がないので、共通の頂点を作った。
062 <span>AtCoDeerくんと立方体づくり</span>
問題文:
■ 自分の提出:
■上下を固定する方針はすぐに立った。あとは、上下に使ったものは周りに使わないとか、周りに同じ種類のものが必要な場合の処理とか、タイルは回転しても良いとか、単純なのに微妙に処理の多い問題だった。
063 <span>木と整数</span>
問題文:
■ 自分の提出:
■矛盾しない範囲を持ってdp。似たような問題が他にもあったような。あとは、木グラフで何かをやる場合、まずは線分状のグラフ(区間)の場合に何をすべきかを考えるとかも発想の足がかりとして良いことが多い気がする。
064 <span>Cosmic Rays</span>
問題文:
■ 自分の提出:
■ダメージ $0$ で動き回る様子を考えていると、円の間に連結成分を作っている感じになる。連結成分間の移動を考えると、単に最短路問題に帰着された。連結成分は長さ $0$ の辺で結んでおくだけでよい。scipy.sparse.csgraph を扱う場合、長さ $0$ の辺を自動的に辺がない場所とみなす場合があるので注意が必要。
065 へんなコンパス
問題文:
■ 自分の提出:
■難しかった。確かに、座標変換(回転拡大)して一様距離に書き換える方が考えやすかった。
半径は一定で、適当な連結成分上の辺の個数を数える問題だと思える。偏ったデータで答が$O(N^2)$ となる場合がある($2$ 本の平行線上に密に並べる)ため、 $1$ 本ずつ見ていては条件を満たす線分だけに注目できたとしてもアウト。何かしらでまとめてやりくりする必要がある。
ということに注目して考えていると、まずは各頂点に対して距離 $R$ (半径)の点の個数を取得する方法が分かる。でも結局これらを全部連結にしていこうとすると1つ1つ見なきゃいけなくて、上手くいかない。
最終的には、2つの課題を切り離して考えることが有益だった。連結成分を拡大するときには、未注目の距離 $R$ を全て順番に見ていく。連結成分の拡大は $O(N)$ 回しか起こらないのでこれでよい。一方、辺の数を数えるときには1つ1つ見ていくのではなく、全部一括で個数だけ拾うようにする。
066 <span>Addition and Subtraction Hard</span>
問題文:
■ 自分の提出:
■ちょっと長めの式を書いて試す。$a-b-c+d-e-f+g+h-i-j$ のような式があった場合、$b$は諦めて
・$a-(b-(c+d)-e-(f+g+h)-i-j$
と他は全部プラスで回収できる。$a-b+c+d-e-f+g+h-i-j$ だったら、$c$の処遇次第で
・$a-((b+c+d)-e-(f+g+h)-i-j)$
・$(a-b) + c + d – (e – (f+g+h) – i – j)$
のどちらか。引き算後のグループをまとめて見捨てるか、第1項だけ引き算を完結させて残りで頑張るか。
067 <span>Grouping</span>
問題文:
■ 自分の提出:
■基本的な数え上げ・漸化式。
068 <span>Snuke Line</span>
問題文:
■ 自分の提出:
■品物から考えても、列車から考えても、結局1件ずつ拾う形になってしまうとダメ。何かをまとめて数える必要がある。
難点の1つは、同じ品物は1回までしか買わないところにある。これがなければ、各点に対して左側にある $L$ と右側にある $R+1$ を集計すればよい。一方、2回以上買う可能性のある商品は、長さだけを見れば確定購入なので、こちらはまとめて集計できる。
PyPy使用。
069 <span>Frequency</span>
問題文:
■ 自分の提出:
■比較的易しい。実際の山で計算してみると、かなり単純なアルゴリズムだ。計算するべき回数も、複雑な計算を必要とする数値ではない。
070 NarrowRectangles
問題文:
■ 自分の提出:
■難問。何か分かりやすい解法があるのではないかとしばらく考えるも、特に簡単にならない。
下から順に「関数ごと更新していく」感じの漸化式を考える。$n$ 段目の長方形の座標ごとに、$n$ 段目までの最小値を持つ関数を $f_n$ とすると、$f_{n+1}$ は
\[ f_{n+1}(x) = \lvert x-a\rvert + \min_{-b\leq t\leq c} f_n(x+t) \] のような式で書けることが分かる。このことから、$f_n$ が常に局所 $1$ 次関数であること、傾きは至るところ整数で、下に凸になることなど、形状がおおよそ定まっていく。
そもそも「関数全体を持って、更新していく」とやるのは無理があり、データで扱える形(有限個の整数や実数の組)で関数を表す必要がある。これは、ここまで関数の形が限定されたのでできる。傾きの変化点を持つことにした。あとはまぁ一直線に、といってもそれなりにテクい。平行移動して $\min$ をとるところで、傾きの変化点が一斉に平行移動される。これを全ての値に定数を加えていては計算量が大きすぎる。ただ、これは「真の値はこの値からいくつ足されたものですよ」という情報を1つ余分に持つことで対応できる。
実装は、ABC 127-F と似た雰囲気であった。これは当時のコンテストで、場合分けの多い複雑なコードを書いてしまったせいで、バグが取り切れず解ききれなかった問題。他の方のコードを参考にしてミスしにくい実装を考えながらしっかり反省した問題だったので、その経験が活きて、本問題では実装は苦戦しなかった。
push_L = lambda x: heappush(S_lower, -x)
push_R = lambda x: heappush(S_upper, x)
pop_L = lambda: -heappop(S_lower)
pop_R = lambda: heappop(S_upper)
この辺は、初の試みだが、コードが書きやすくなって良かった。heapqに格納して最大値を取り出せるようにするやつ。他には、傾きが $-1$ から $1$ に変化するところは、同じ点で $2$ 回傾きが変わると見なして統一的な実装をするなど心がけた。
071 <span>TrBBnsformBBtion</span>
問題文:
■ 自分の提出:
■これは易しめ。操作が可逆。$\pmod{3}$ で不変量がある。
072 <span>Alice in linear land</span>
問題文:
■ 自分の提出:
■ゴールから遡って、ダメな値の集合を更新していけばよいことはすぐに分かる。
単純に見ると更新量が多すぎるが、数回手計算していると、最小値だけ持てばいいよねってことが分かった。
073 <span>Ball Coloring</span>
問題文:
■ 自分の提出:
■ボールがたくさんあるが、最終的には4つの値が残るだけ。しかも、全ボールの最大値と最小値は必ず生き残る。一番難しい部分は、最小化したいボールが1色だけの問題だった。ここも、ソートして$O(N)$ くらいのとり方を試せば良い。
074 <span>RGB Sequence</span>
問題文:
■ 自分の提出:
■適当な状態にまとめてdp更新していきたい。$R$番目を並べているときに、$[L,R]$ の条件を満たせているかを分かるようにしなければいけない。そのためにどういう状態を持たせておけばよいのかを考えると、各色が最も最近現れた位置に注目すればよいというのは自然だった。
075 <span>Meaningful Mean</span>
問題文:
■ 自分の提出:
■易しめ。$K$ ずつ引けば、和が $0$ 以上の区間を検出する問題に帰着。区間和を見たいので、累積和を持つことを考える。すると、転倒数の計算に帰着される。
076 <span>Connected?</span>
問題文:
■ 自分の提出:
■位相幾何という考え方を知っていると少し易しくなる?内部に線分があっても、連続的に1点に縮めて考えられる。全部できちゃう?と思って問題文とサンプルをもう一度見ると、両端点が長方形の境界を結ぶ場合が本質だと分かる。あとはソートしてそれっぽく。ソートは、中心と結んだ角度で行った。
077 <span>guruguru</span>
問題文:
■ 自分の提出:
■お気に入りの値を $x$ とすると、各課題$a_i\mapsto a_{i+1}$に対して必要回数 $f(x)$ が出来る。これを全ての課題に対して足していけばよい。$f(x)$ そのものを更新するのはしんどい。傾きが$0$, $1$ の $1$ 次関数をつないだ形。よって、差分 $\Delta f(x) = f(x) – f(x-1)$ を持つことにする。これは局所定数関数。さらに $\Delta \Delta f(x) = \Delta f(x) – \Delta f(x-1)$ を考える。これはほとんど至るところ $0$ なので更新が容易である。$\Delta \Delta f$ の課題に対して集めて、そこから $f$ を復元すればよい。
078 Awkward Response
問題文:
■ 自分の提出:
■インタラクティブ問題はほとんど経験なし。どうデバッグ環境を作るか悩んだ。解を適当に生成して、応答用の関数を作った。
数値順と文字列順は、桁数が同じなら一致する。まず文字列順が自明な問題を投げて桁数を特定。次に数値順が自明な問題を投げることで文字列順を二分探索した。
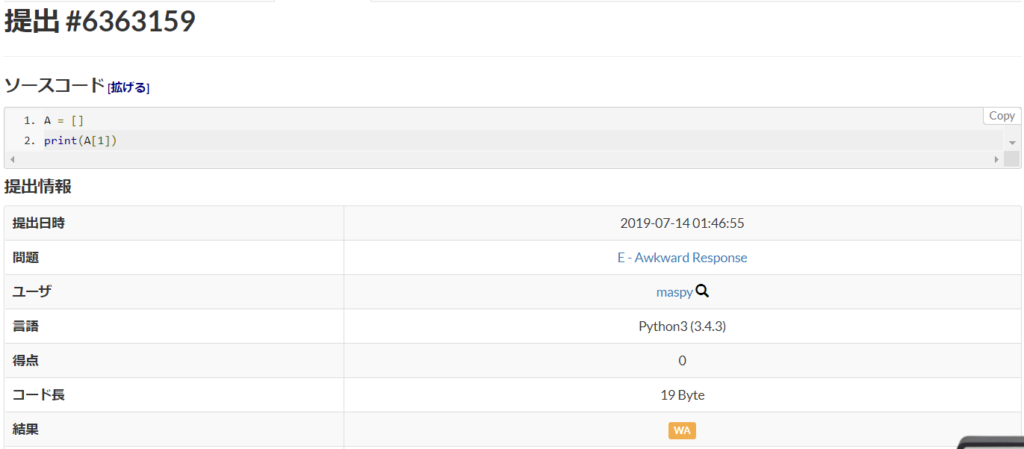
インタラクティブ問題では、REがWAと判定される??
079 <span>Decrease (Judge ver.)</span>
問題文:
■ 自分の提出:
■回数を与えると、$N-1$ 以下に到達できるかが判定できる。したがって、二分探索で良さそう。
と思いきや少し面倒な要素があって、$N-1$ 以下に到達している回数全体が単調にならない。一度到達してもまた戻ってしまう場合がある。
しかし、そこから $N$ 回やると全部 $1$ ずつ減少、したがって $N^2$ くらいやれば永久に $N$ を超えなくなるので、二分探索で出した値は大きく見積もっても誤差 $N^2$ 程度。個別の回数に対して結果をテストできるので、あとは全部調べても計算量十分。
080 <span>Young Maids</span>
問題文:
■ 自分の提出:
■やるべきことはすぐに分かったが、地味に実装がややこしい。辞書式順序なので、最後の操作から考えて戻っていく。奇数番目、偶数番目だけ見て最小値を並べる。ここはRMQ。
奇数番目、偶数番目を拾うと、狭い区間に分割される。これらの区間から、また最小の奇数・偶数を拾う感じ。最初は小区間に対する計算結果を持ってマージソートのような方法を考えたが、計算量が悪い。最小のペアをqueueに入れておいて、それを採用したときに次の計算を始める形で考える。これを行うために、(最小のペア、それを採用したら次に計算するべき場所一覧)というデータをqueueに持たせることで実装できた。
081 <span>Don't Be a Subsequence</span>
問題文:
■ 自分の提出:
■長さ$n$の文字列なんて$26^n$もあるので、答えは十分小さいかと思ったが、部分文字列も$2^N$通りあるので全然そんなことはなかった。abcabc のような繰り返しだと、$O(N)$ の長さの答になる。a,b,cを15個くらい適当に並べて手で解いていると、後ろから決めていいことが分かった。
最終的には、各$n$に対して、n番目以降でa,b,cが現れる最初の位置、および、そこから開始したときの作れない最長部分列を持ってdp。
082 ConvexScore
問題文:
■ 自分の提出:
■たまたまかなりすぐに思いついたが、はまるとかなりの難問かもしれない。
スコアの定義が怪しいなと思い考えていると、2べきの部分を部分集合の個数と思う発想になった。この言い換えさえできればあとは簡単。だいたい $N$ 元集合全体の部分集合の個数を数える問題になって、$2^N$ くらいの答になる。あとは凸包がつぶれてしまう場合だけ修正。
083 <span>Bichrome Tree</span>
問題文:
■ 自分の提出:
■入力例3を手で解きながら考える。下から決めていくのだが、白黒はくっつけるときに選び方を決める。ある頂点を塗るときには部分木の(白の合計・黒の合計)という組がいろいろあるが、一番無駄のない選び方があるのでよい。
084 <span>Finite Encyclopedia of Integer Sequences</span>
問題文:
■ 自分の提出:
■中央値を連打していけば、大体真ん中になるだろうことは直感的にも分かる。これで上手くいかないことは、入力例などを手計算してみればズレの原因が分かる。ずれは十分小さいので、ひとつずつ戻ればよい。
085 <span>MUL</span>
問題文:
■ 自分の提出:
■難しかった。$6$ 個の場合の制約関係を絵に書きながら、最小カットっぽさを感じとる。うまくグラフを作れば最大流・最小カットの類になるのだろうと信じて1時間くらい粘っていたら、上手くいった。
こういうのはどのくらいパターン化できるものなのか。他の方のブログ等をめぐると、埋める・燃やすとかProject Selectionとかいう類の名称である程度知られている考え方っぽい。いくつか読ませてもらいました。どの程度身についたのかはあまり自信がないが、次回に活きるといいな。
086 <span>Smuggling Marbles</span>
問題文:
■ 自分の提出:
■これは難しかった。というか、最終的な解答はかなり自然なことをやっているだけなのだが、ほんの少し実装法を変えただけなのに計算量が大丈夫になるところが分かりにくい。
根から順に、各時刻にコインが $0$ 枚、$1$ 枚となるような確率を持つのは自然。複数の根から合流するところは、$0$枚、$1$枚、$2$枚以上と分けてマージしていけばよい(ここもまぁまぁ悩んだ)。最終到達時刻ごとに計算すると、$O(N^2)$ になってしまう。全時刻のデータを同時に持って、共通の深さ分だけマージする形にしてあげる。各頂点に最初にあったコインはマージ元側になるのが1回以下になるので、$O(N)$ になる。
087 <span>Prefix-free Game</span>
問題文:
■ 自分の提出:
■prefixの関係を図示すると、完全二分木ができる。これに禁止ルールを追加していくと、完全二分木に分解されることが分かる。よって、それらのgrundy数をxorすればよい。
完全二分木のgrundy数は、最初にどれをとるかで場合分けして、計算できる。が、深さ $N$ の場合を計算するのに、これまでの数表を持った上で $O(N)$ の計算が必要。問題は $10^{18}$ までを要求しているので、もっと簡単に計算できないとまずい。
ゲームのgrundy数は、理論的な導出というよりも、しばしば小さい数で実験して規則を見つけるという方法が使われる(見つけられれば証明は易しい)。今回も、小さい場合を計算させてみて、規則を予想・証明する形をとった。
088 <span>Papple Sort</span>
問題文:
■ 自分の提出:
■文字列を見れば、各文字が左側に行くべきか右側に行くべきかが決まる。左側の並びを入れ替える利点がないことが確認できる。したがって、何番目の数が何番目に行き着くかが計算できる。あとは恒例の転倒数の計算。
089 GraphXY
問題文:
■ 自分の提出:
■各経路の距離が、$X$, $Y$ の1次式になる。1次式の集合があり、各 $x,y$ に対する最小値が与えられていることになる。
最小値に対してどのような $1$ 次式を追加していけばよいのかを考えたが、全然進展しない。まず、$1$次式は作りすぎてもよいことに気づく。つまり、任意の $(a,b)$ に対して $ax+by+c$ という式を1つずつ作ることにする。$c$ を十分大きくすれば、$1$次式を作らなかった場合と同一視できる。
この着想が良かったのか、各 $(a,b)$ に対してどのような $c$ を持てるかという視点を得る。これは簡単だ。与えられた最小値群を下回らない範囲でなるべく小さい $c$ を選べば良い。ここまでできれば簡単で、$ax+by+c$ を下側に矛盾しない範囲で最善の作り方ですべて作って、条件を満たすかの検証をすれば良かった。
いろんな $a,b,x,y$ に対する計算をまとめていたら、numpyの4次元arrayになった。
090 <span>Avoiding Collision</span>
問題文:
■ 自分の提出:
■衝突を引けばよい。2度衝突することはないので、重複して数えるような心配はいらない。各頂点、辺に対して衝突を数えればよい。これは、各頂点に対して経路長・最短経路数を計算していくだけなので、典型的な最短路アルゴリズム。
091 LISDL
問題文:
■ 自分の提出:
■$nm+1$ 項あると、$(n+1)$ -増大列または$(m+1)$ -減少列が出来てしまうことが分かる。これは、帰納法しようとしてみるとすぐに証明できる(提出ソースのコメント)。解説PDFはもう少しテクい方法をとっていた。
092 <span>Both Sides Merger</span>
問題文:
■ 自分の提出:
■実験していると、奇数番目・偶数番目どちらかしか生き残らないことが分かる。また、奇数、偶数番目の任意の部分集合の和がとれる。
093 <span>Bichrome Spanning Tree</span>
問題文:
■ 自分の提出:
■最小全域木の重みが$x$であれば、$X> x$なら最小全域木は同色でなければいけない。というのが最初の気づき。ここから「ある最小全域木に含まれる辺は全て同色」と言いたいが、例えば最小全域木が $A,B$ の2つしかなくて、これらが共通の辺を持たない場合、「それぞれ同色」までしか言えない。しかしそういうことはなさそう。同様に、「ある重み$X$未満の全域木に含まれる辺が同色」も証明できそう。
証明は解説PDFにもあまり明快に書かれていないように思う。結局次が成り立つ:
【命題】 $G$ を辺に重みがついたグラフ、$T$ を最小全域木のひとつ、$e$ を $T$ に含まれない辺とする。このとき、$G$ の全域木で $e$ を含むもののうち重み最小のものは、$T$ に $e$ を加えて、できる閉路から $1$ 辺除くことで得られる。
これは、例えば最小全域木がクラスカル法で計算できることから分かる。「$e$ を必ず含む」という条件下での最小全域木を求めることは、$e$ を縮約したグラフ上での最小全域木を求めることと等価。すると、クラスカル法のアルゴリズムが、$e$ の端点の連結成分をつなぐ部分を除いて同等に再現される。
この構成より、最初に最小全域木 $T$ をひとつとり固定すると、$T$ は単色。
ある辺 $e$ を含む全域木の最小コストが $X$ 未満であれば、その全域木は $T$ と辺を共有するものにとれるので、$e$ も $T$ と同色であることが分かる。結局 $e$ を含む全域木の最小コストが $X$ より小さい・等しい・大きいのグループごとに、単色、逆色があればよい、自由、などという単純な条件になり解けた。
「$T$ に $e$ を加えたときにできる閉路上の1辺」の長さを計算する必要があるが、ここはLCAの計算時に辺の長さの最大値も持たせればよい。
094 <span>Tozan and Gezan</span>
問題文:
■ 自分の提出:
■冷静に実験してみると、基本的に先手がやりたい放題できることが分かる。後手は1箇所防衛するので精一杯。
095 <span>Symmetric Grid</span>
問題文:
■ 自分の提出:
■縦の並びは $12!$ 通りあるが、どの行同士がペアになるかだけ見ればよいので、$11\cdot 9\cdot 7\cdot 5\cdot 3\cdot 1$ 通りしかない。縦の並びを固定すると、列をペアにできるかの判定になる。列を対応できるかでグラフを作って完全マッチング判定、かと最初思ったが、複雑なグラフを見るわけではなく同値類に区切っていく感じなのでペアがあれば貪欲にとっていく形でよい。
地味に、奇数・偶数での実装の共通化など悩んだ。
096 <span>Everything on It</span>
問題文:
■ 自分の提出:
■包除の原理というのはすぐに思う。$k$ 元集合が少なくとも反例となっているような場合を数えればよい。ここでさらに、$0$回のものと$1$回のものに分けて扱うと計算量が落ちなかった。
1回だけ取るものは、どうグループ分けするのかを調べたいが、ここを、$k$ 元集合をグループ分けしてから1グループ以下を$0$回のものに振り分けることで計算量が落ちた。いずれにせよ、べき集合のべき集合みたいなものが絡む数え上げでなかなか混乱しやすい。
097 <span>Sorted and Sorted</span>
問題文:
■ 自分の提出:
■制約を見て、$O(N^2)$ かな?と思ったことで難易度が下がった。左からどの番号の白・黒まで並べるのに何手かかるかという $N^2$ 個の値を計算しようと思えば、あとは自然。
098 <span>Range Minimum Queries</span>
問題文:
■ 自分の提出:
■使える最小値を固定すれば、禁止地点ができて、区間ごとに回収できる個数が決まり、回収してソートすると最大値が出る。あとは、これを動的に最小値を変化させながら計算すればよい。
一度加えたデータを削除するより、値を追加していくほうがやりやすいので、最小値が大きい場合から考えて通行止めを解除していく形で考えた。通行止めを減らすと、回収できる区間が広がり、大きい方から$K$ 個を除いて取得可能になる。各座標ごとに、左右どこまでの区間を考えているかの値を持ってマージしていく。$K$ 個残して小さい方から捨てるところは、あまり経験がなかったheappushpopを使った。
099 Independence
問題文:
■ 自分の提出:
■補グラフが二部グラフと言い換えるのも、それほど難しい発想ではない。連結成分ごとに二部グラフの判定をする。あとは成分ごとの大きさの分け方をマージして、全体の最善のグループ分けを求める。
100 Or Plus Max
問題文:
■ 自分の提出:
■bitwise_orは、集合の和集合に対応する。$i\cup j \subset k$ となる $(i,j)$ に対する計算をする。これは$i\subset k$ かつ $j\subset k$ と同値なので考えやすい条件。$A=\{a_1,a_2,\ldots,a_n\}$ の部分集合は、ある $i$ に対して$A\setminus \{a_i\}$ の部分集合であることと同値なので、より小さい集合の場合の $n$ 個の計算から $A$ の場合が計算できて、計算量は $O(N2^N)$。
同じ数を2度使わないようにしないといけないところで最後にはまる。ここは、上位2件を持つことで解決。
101 Ribbons on Tree
問題文:
■ 自分の提出:
■通行止めする辺集合を決めると、各連結成分上で自由にペアを作る問題になるので包除の原理が使えそう。これまでいくつの反例を決め打ったか(偶数・奇数)、および、次に反例集合を広げる更新のために自由に使える部分の連結成分を持つ必要がある。
これは実装中に気づいたことで、反例の偶数個から奇数個を引いた差分だけ持って更新していく形で上手くいった。連結成分も辺の個数とか頂点の個数なのかとかで混乱しやすく、無限にバグを出した。
def dp_merge(data1,data2):
    N1 = len(data1) - 1
    N2 = len(data2) - 1
    if N1 > N2:
        N1,N2 = N2,N1
        data1,data2 = data2,data1
    data = np.zeros(N1+N2, dtype = np.int64)
    for n in range(1,N1+1):
        data[n:n+N2] += data1[n] * data2[1:] % MOD
    data %= MOD
    return data
ここの処理で、データ長によって番号を入れ替えています。ここは2次元配列を1次元分高速化するようなことをやっているのですが、細かい枝をマージするときに、「長さ $N$ の配列と長さ $2$ の配列」というようなケースが多発していて、長さを入れ替えないと、長さ $N$ をpythonループ、長さ $2$ だけnumpyという感じになってTLEしていました。やってることは大体畳み込みで、np.convolveを使うと桁あふれしちゃうので処理を分解しています。
102 <span>Stop. Otherwise...</span>
問題文:
■ 自分の提出:
■計算すべきものがかなり明確で易しめ。両立し得ないペアがいくつかあり、そのうち何組かの片方だけを使い、他は使わない。その個数で場合分けしてあげれば、二項係数とか2べきとかをごちゃごちゃ掛け算すれば計算できる。
103 <span>Tr/ee</span>
問題文:
■ 自分の提出:
■端から作っていく。各段階で、禁止されている大きさの連結成分ができないように作っていけばよい。